Programación
Notas, proyectos y temas afines. Así como escribo para organizar ideas, programar algoritmos también permite una comprensión más profunda de los métodos y sus detalles. La llegada de los LLM ha permitido que rescate mucho código que he escrito durante décadas, organizando mejor en repositorios de github cuando creo que vale la pena.
Algunos proyectos
- GradienViz, febrero de 2026. Visualizador de optimización por gradiente, con raíces en programación numérica. Entrada completa en la sección de IA.
- paranoia2, verano de 2026. Un verificador de los tipos binarios de la norma IEEE 754 de 2019.
- Lebesgue, febrero/abril de 2026. un comparador visual de las integrales de Riemann y Lebesgue.
- CUDA, verano de 2024, el inicio de programas de alto rendimiento.
- Monografía de mi sabático, 2007/2008. Trabajo comenzado en la UNISON en 2007 y terminado en la UABCS. Presenté la monografía al regresar, pero continué desarrollándolo unos años más hasta darle la forma que quería.
- Regresión Lineal agosto de 2020. Para un curso de posgrado, programado en Processing.
- PromedioImg agosto de 2020. Ejemplo de PDI para estudiantes visitantes del Tec de Mulegé.
Topología geométrica/combinatoria
- NautyNav, agosto de 2026. Visualizador de grafos generados con
geng.c. - SmallGraph/TinyGraph, *2015 - *. Grafos he programado desde la licenciatura en la UNISON, pero aquí comencé a tener rutinas serias.
- KnotViz, mayo de 2026. Un visualizador de nudos y algunos de sus invariantes.
Del baúl de los recuerdos:
- Cómo comencé a programar, julio de 2026. Del Basic en adelante
- Mi tesis de licenciatura, verano de 1993.
- PAREIMM, 1992/1993. Un esfuerzo conjunto de estudiantes de Pedro Flores Pérez
- MkTree, 1993. Un programa tipo caballo de batalla.
GradienViz
Enero de 2026
Herramienta pedagógica para diversos cursos sobre el tema de regresión lineal. Implementada en p5.js como un único archivo HTML autocontenido — no requiere instalación ni servidor.
Ver la entrada completa, con capturas y más detalle, en la sección de IA.
NautyNav
Agosto de 2026
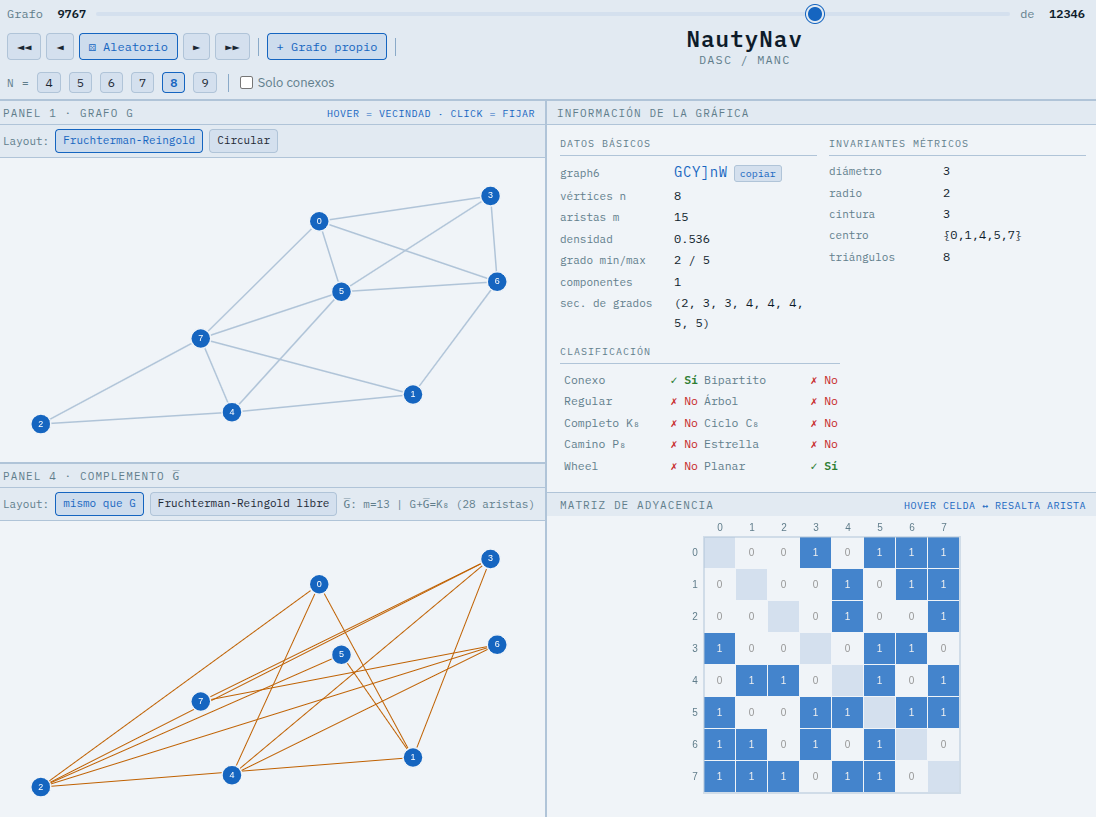
Explorador interactivo de grafos no isomorfos generados por nauty/geng. Es una herramienta didáctica para cursos de teoría de grafos y matemáticas discretas. Implementada en p5.js como un único archivo HTML autocontenido — no requiere instalación ni servidor.
Funcionalidades
- Panel 1 — Grafo G con layout Fruchterman-Reingold. Hover sobre un vértice muestra su vecindad N(v) y grado; click fija la selección.
- Panel 2 — Datos básicos, clasificación automática (Kₙ, Cₙ, Pₙ, K₁,ₙ-₁, Kᵣ,ₛ, Wₙ) e invariantes métricos (diámetro, radio, cintura, centro, triángulos).
- Panel 3 — Matriz de adyacencia interactiva. Hover sobre una celda resalta la arista correspondiente en Panel 1.
- Panel 4 — Grafo complemento G̅, con opción de mismo layout que G o layout FR independiente.
- Navegación en el slider (arriba), botones ◄◄ ◄ ► ►► y aleatorio; filtro para grafos conexos.
Permite navegar visualmente por todos los grafos no isomorfos de orden n (4 ≤ n ≤ 9), mostrando en tiempo real sus propiedades estructurales y algebraicas.
Puede usarse directamente en mancpato.github.io/NautyNav, no requiere instalación. Para usarlo, empieza eligiendo la cantidad de nodos n en la parte de arriba y luego usa el deslizador o las flechas para navegar entre grafos.
Puede ser de utilidad en cursos de Matemáticas Discretas o Teoría de Gráficas. El repositorio se encuentra en github.com/mancpato/NautyNav.
Era fácil de hacer, como subproducto de un proyecto mayor que permite hacer búsquedas exhaustivas para diversos proyectos.
SmallGraph
2015 en adelante
Comencé a programar grafos desde la UNISON, gracias a que Pedro Flores estaba metido en optimización y luego de trabajar matricialmente con el método Simplex, decidió meterse a optimización de flujo en redes. Los que estábamos en sus cursos optativos éramos Edelmira, Irene, Myriam y yo.
La primera versión de grafos era por listas de adyacencia usadas de manera descuidad. Optimizábamos memoria pero no tiempo, cosa que entendí hasta llegar al CINVESTAV. Me han seguido gustando los problemas de grafos y no fue sino hasta 2015 cuando me regresó la curiosidad por hacer una estructura de datos eficiente, empleando matrices de adyacencia, pero con máscaras de bits.
Con la actual arquitectura de 64 bits, me decidí por trabajar rutinas exclusivamente para grafos con un máximo de 64 nodos, lo que significaba un arreglo de 64 enteros largos sin signo. Con esa idea surgió SmallGraph. Primero en lenguaje C, fiel a mi origen, pero pocos años más tarde lo mudé a C++, con una clase SmallGraph.hpp.
En 2025 leí un artículo de mis amigos de la UNISON Eduardo Frías y Héctor Hernández, con quienes no he perdido contacto. Estaban contando grafos con ciertas características, problemas de contractabilidad. El artículo hacía referencia a un repositorio con su código, que cloné y revisé en cuanto pude. Usaba la arcaica e ineficiente estructura de matrices de adyacencia pero con matrices reales de enteros. De inmediato me surgió la idea de probar mis estructuras con sus programas.
Los grafos distintos crecen tan rápidamente, que sus conteos y búsquedas estaban en grafos de 12 o 13 nodos cuando mucho, así que adapté los algoritmos a usar enteros cortos de 16 bits, lo que es amigable con el caché. Surgió así TinyGraph.hpp. Las vacaciones navideñas de 2025 estuve programando y finalmente logré replicar sus búsquedas. La mejora en tiempo fue sustancial, como era de esperarse.
Con esta estructura y unas pocas semanas de cómputo 24/7 de mi PC de la UABCS (viejita, un intel i3 con 4 núcleos), logré contar todos los grafos de 13 nodos en busca de aquellos con las características de interés. Espero pronto escribir una entrada específica al respecto.
Este fue de mis primero programas optimizados con con ayuda de IA, que hizo una lookup table para reducir cálculos y mejoró una rutina incorporando la nueva operación popcount de los procesadores modernos.
KnotViz
Mayo de 2026
Visualizador interactivo de nudos y algunos de sus invariantes. Los nudos (matemáticos y cotidianos) siempre me han gustado. Pero fue hasta la pandemia cuando leí con un poco más de seriedad el tema matemático, y no estaba preparado para tanto bagaje teórico, así que me conformé con muy poco.
Pero mi amiga de la UNISON Gaby Hinojosa publicó un paper que me hizo recordar estos intentos y decidí dejar un poco los grafos para indagar sobre estructuras para representar y operar con nudos. No tenía idea del camino tan complicado que estaba tomando, comparado con las matrices de adyacencia de grafos representadas con operaciones bit a bit.
Un nudo es una curva cerrada en el espacio tridimensional y su estudio se basa en la representación de diagramas planos que capturan su estructura topológica. Para representar un nudo se necesita una estructura de datos que pueda codificar tanto la conectividad entre los segmentos del nudo como la información de los cruces (quién pasa por encima y quién por debajo) y la orientación local en cada cruce (la dirección del trazo).
Esto requiere combinar varios ingredientes simultáneos:
- embedding planar (sistema de rotación), que ya trae consigo la conectividad, pues el orden cíclico de aristas alrededor de cada vértice la presupone,
- dato del cruce (over/under) y
- orientación (dirección del trazo).
Hay tres representaciones canónicas clásicas:
- Gauss Code (código de Gauss), que guarda la secuencia de cruces a lo largo de un recorrido del nudo,
- Código de Diagrama Plano, que describe explícitamente su estructura como un grafo planar con información de cruces y orientación y
- el código de Dowker-Thistlethwaite, aprovecha que al recorrer el nudo cada cruce recibe dos números, uno par y uno impar, y para cada cruce (identificado por su etiqueta impar) guarda el número par correspondiente con signo según si el paso es por encima o por debajo, codificando así de un jalón la identidad del cruce y el dato over/under.
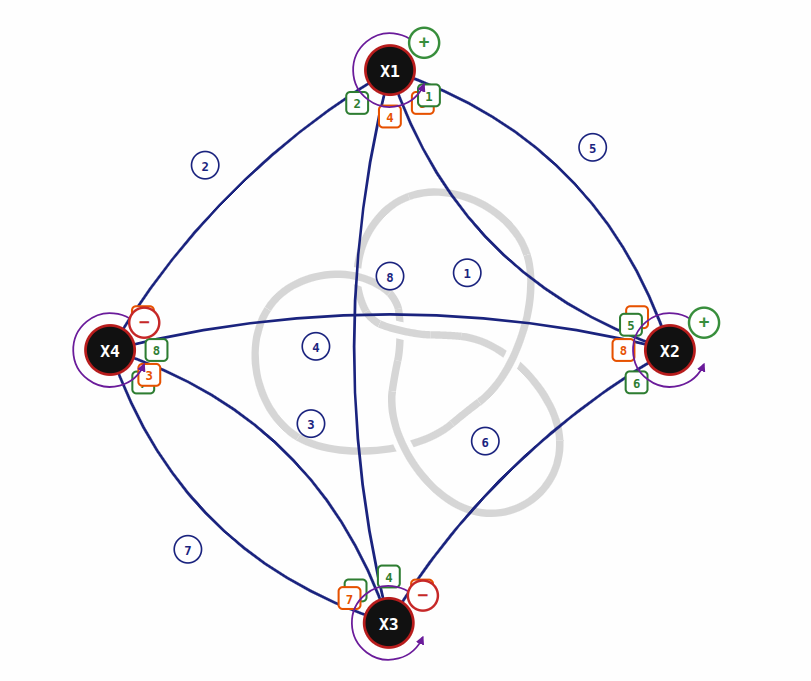
Sin embargo, para algoritmos más avanzados, es útil una representación más rica que combine estas capas. La idea es representar el nudo como un grafo planar embebido con un sistema de rotación que codifica la orientación local en cada vértice. Esto permite manejar de manera eficiente tanto la conectividad como la información de cruces y orientación en una sola estructura de datos. Debo decir que ha sido un verdadero dolor de cabeza, pese a la ayuda de las IAs.
Implementada en p5.js como un único archivo HTML autocontenido — no requiere instalación ni servidor.
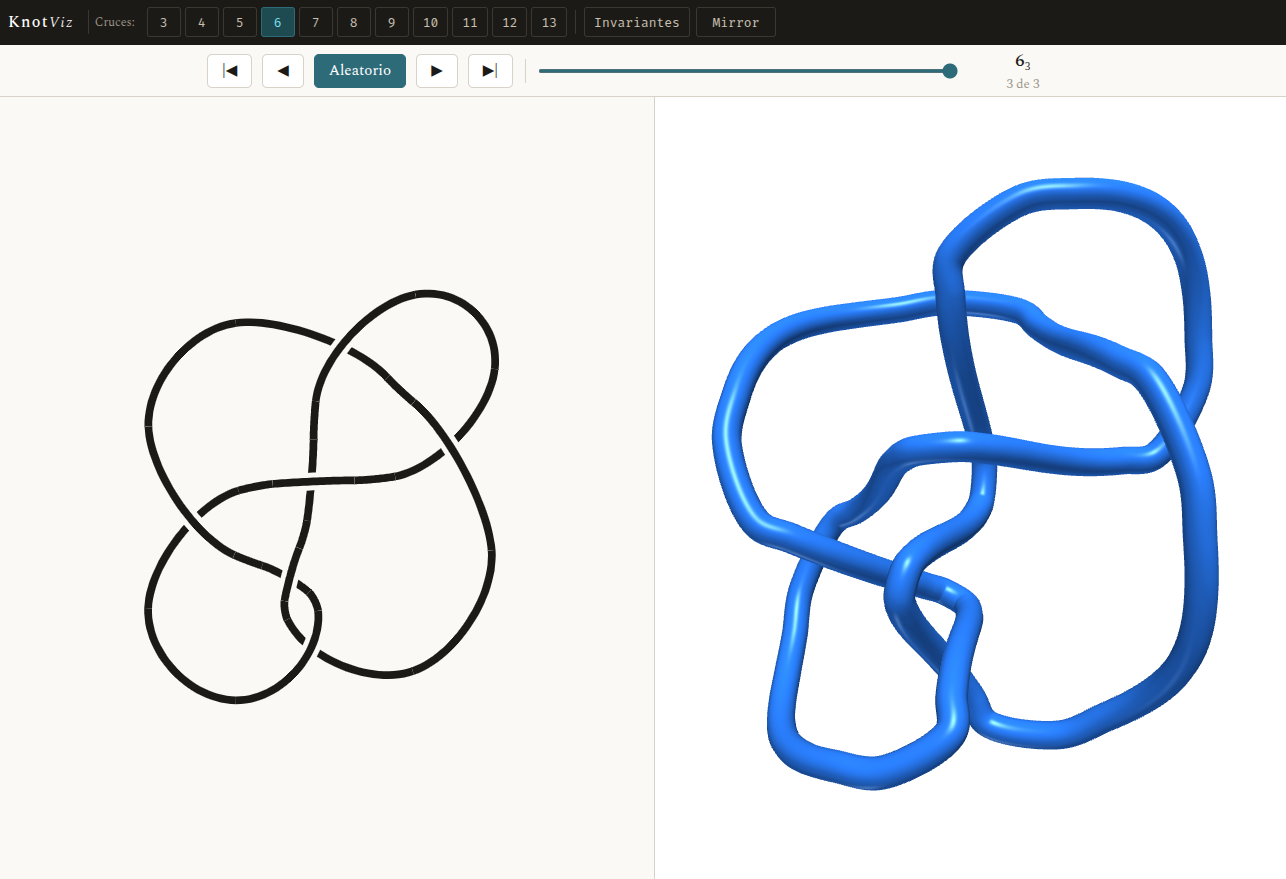
Puede usarse directamente en mancpato.github.io/KnotViz, no requiere instalación. Espero que sea de utilidad en cursos de teoría de nudos, aunque en la UABCS no hay una asignatura sobre el tema.
El repositorio se encuentra en github.com/mancpato/KnotViz.
Paranoia2
Julio de 2026
En 1983, el analista numérico William Kahan programó paranoia.bas, un programa que buscaba defectos en las computadoras de la época. Cada una hacía cuentas a su propio estilo, lo que llevaba a que el mismo programa diera resultados distintos si se cambiaba de computadora. Fue el arquitecto principal de la norma 754 de IEEE, que rige cómo las computadoras deben hacer los cálculos, algo que a la gran mayoría de las personas les pasa desapercibido pero lo usan todo el tiempo. Sus trabajos le ganaron la medalla Turing, el equivalente al Nobel en computación.
Conocí el programa traducido paranoia.c y es una maravilla de genialidad. Hoy por fortuna casi toda computadora cumple la norma. paranoia2 es un verificador del cumplimiento de la norma 2019, para formatos binarios (la norma incluye base 10, pensado para cuestiones económicas).
El repositorio se encuentra en github.com/mancpato/Paranoia2. Puede ser de utilidad para interesados en los detalles finos de programación numérica. Este es material denso y muy técnico.
paranoia2 verifica conformidad IEEE 754-2019 en los cuatro formatos binarios — binary16, binary32, binary64, binary128 — cubriendo las operaciones aritméticas básicas y sus cinco modos de redondeo, fma, fronteras de redondeo y el bit sticky, las cinco banderas de excepción, las operaciones requeridas de §5 (nextUp/nextDown, scaleB, logB, remainder, roundToIntegral, predicados), aritmética de infinitos y NaN (payload, signaling/quiet), comparaciones y totalOrder, subnormales (incluido FTZ/DAZ), overflow, conversiones binary↔binary, operaciones de bit de signo (negate/abs/copySign/copy), secuencias hexadecimales externas, convertToInteger (§5.8: las cinco direcciones de redondeo, en variante Exact y normal, hacia int32_t/int64_t/uint32_t/uint64_t), y la constatación de qué operaciones recomendadas de §9.5 están disponibles en la plataforma.
Importante: Los formatos decimales, incluidos en la norma, NO se verifican.
Incluye un hito de confiabilidad propio: invariancia frente al nivel de optimización de compilación — el mismo hash SHA-256 del JSON de salida del banco compilado con -O0/-O2/-O3/-Og — evidencia directa de que el banco mide la plataforma que se está evaluando, no el compilador que se usó para construir el propio banco.
El desarrollo contó con la invaluable y extensa asistencia de Claude (Anthropic) a lo largo de todo el proyecto:
- análisis del texto normativo IEEE 754-2019,
- diseño de arquitectura y módulos,
- verificación de casos de prueba con aritmética exacta (Python fractions.Fraction) antes de generar cualquier código y
- revisión de kernels e integración.
La iniciativa, idea, interfaces internas, decisiones de diseño, dirección y detalles de documentación son míos.
Lebesgue
Abril de 2026
En los últimos semestres de la licenciatura en matemáticas conocí la integral de Lebesgue y nunca más la volví a usar. Creo recordar que ni le entendí del todo y cada que Lebesgue aparecía en algún documento, sentía una deuda moral como matemático. Siempre pensaba volver a revisar el tema, pero cada vez había algo más importante.
Desde hace años he estado metido en el tema de las redes neuronales y en 2022, regresando de pandemia, me enteré de la Teoría del Aprendizaje Singular (Watanabe), me sorprendió ver a Lebesgue metido como técnica imprescindible de integración y en ese momento se despertó mi curiosidad.
Busqué recursos en Geogebra sobre Lebesgue pero no encontré nada, Geogebra está muy orientado a la integral de Riemann, hasta funciones especiales tiene para eso. No quedó más remedio que hacer una propia. En 2023 me decidí por hacer una en Processing (un dialecto de javascript), una herramienta que me encanta y que he usado mucho para simular algoritmos para IA. Diseñé una interfaz para comparar una con otra y seleccioné las funciones que permitieran ver mejor las diferencias. Por diversos motivos no lo terminé, es una vergüenza, pero me faltó la parte de la integral de Riemann, lo más fácil.
Creo que en ese momento perdí el interés momentaneamente porque el reto mayor es que la comparación luce cuando la partición involucra conjuntos numerables y no numerables. En la computadora, la aritmética de punto flotante limita a sólo un subconjunto finito de racionales distribuidos logarítmicamente, pero eso no tiene por qué detener un programa que hace una simulación. Una vez que logré el objetivo, me entró un poco de flojera por los rectángulos de Riemann y el proyecto se quedó durmiendo el sueño de los justos, durante un año.
En 2026, aprovechando la diversificación de IAs que sirven de eficientes chalanes programadores, retomé el proyecto y terminé lo que faltaba. Finalmente entendía la parte operativa de la integral de Lebesgue.
La diferencia entre ambas integrales no es computacional sino epistemológica: Riemann particiona el dominio (eje X), Lebesgue particiona el codominio (eje Y). Este simulador hace esa diferencia visible e interactiva.
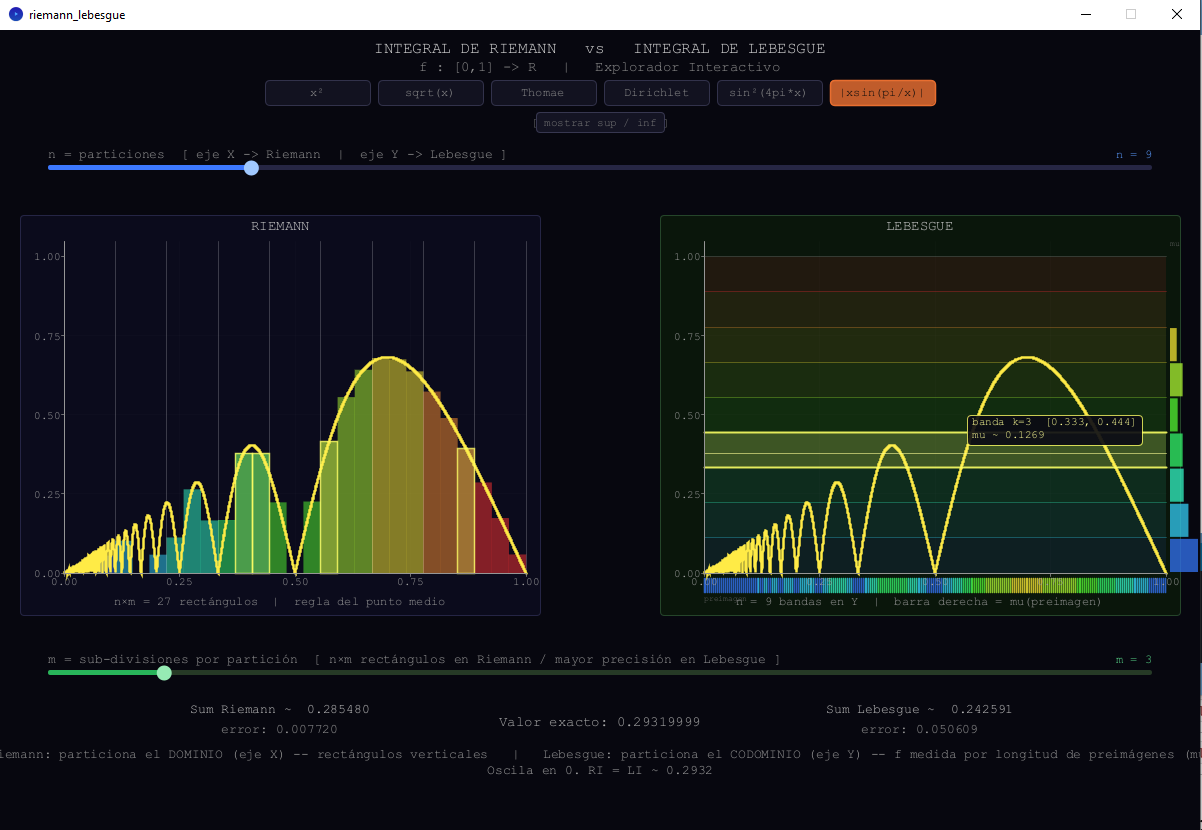
El README del repositorio explica cómo se usa y las funciones incluidas.
Cross-highlight (hover) Es el momento central del simulador: la conexión entre dominio y codominio se vuelve visible en tiempo real. Pasar el mouse sobre un panel resalta el elemento correspondiente en el otro:
- Hover en Riemann → ilumina la banda k en Lebesgue donde cae \(f(x)\)
- Hover en Lebesgue → ilumina todos los rectángulos en Riemann cuyo \(f(x_{mid})\) cae en esa banda
El repositorio se encuentra en github.com/mancpato/01-L-R. En la UABCS no se dan cursos de cálculo tan avanzados, pero me sirvió para entender mejor el tema. Si en algún momento lo uso como parte de una introducción para la Teoría del Lenguaje Singular, estaré muy contento. Por lo pronto, puede ser útil para profesores de análisis en carreras de matemáticas.
CUDA
Primavera de 2024
Había dinero de un proyecto, ya tenía que cambiar de Laptop y eso llevó a comprar una Victus con tarjeta gráfica RTX 3050, aprovechando que estaba en barata. Al inicio, todo normal. Pero luego, mis hijos la usaron para jugar. Máquina gamer a fin de cuentas: Halo, Minecraft, Doom, cualquier juego moderno se veía de lujo. Entonces me cayó el 20 de que estaba desaprovechando un GPU, así que me di a la tarea de aprender a programarlo.
Desde el Hola mundo para CUDA (el modelo y herramientas de programación de NVIDIA) me di cuenta de que eso era pensar distinto. La sintaxis, nueva y engorrosa al inicio, es lo de menos; lo que cambia es la arquitectura mental del algoritmo.
Programar para CPU es como dirigir a unos pocos ingenieros expertos (núcleos) que resuelven tareas complejas, pero lo hacen en secuencia: hay que optimizar instrucciones para minimizar la latencia, cuidar la predicción de saltos y diseñar para usar bien la memoria caché (nuestro aliado en este caso).
Programar para GPU es como organizar a miles de obreros principiantes para que hagan el mismo trabajo con tareas más simples, pero en paralelo masivo. Exige pensar la geometría del problema para llenar miles de núcleos con trabajo idéntico y minimizar la divergencia de hilos. Para colmo, la memoria cache se convierte en un cuello de botella oculto; hay que saturar el ancho de banda, aquí la latencia es secundaria. No todo problema es paralelizable de esta forma.
Me gustó tanto que a fin de año compré una RTX 3060 para mi computadora de la UABCS. Ya quiero dar un curso de introducción a la programación en CUDA, si no, no voy a terminar de aprender.
Monografía de mi sabático
Verano de 2008
Tuve el gusto de invertir mi primer sabático visitando la UNISON en 2007. Ahí regresé a mis mundos de astronomía, guitarra y matemáticas. Me recibieron en el Departamento de Matemáticas y comencé a darle forma a mi libro de programación numérica, una introducción que presenté como monografía al regresar a la UABCS.
Introducción a la Programación Numérica (PDF) Este estudio contiene dos partes, la primera sobre los fundamentos y la segunda sobre tres aplicaciones comunes: la suma de números de punto flotante, raíces de ecuaciones y funciones trascendentes (el caso de la exponencial).
Mi sabático me trae el mal recuerdo de que en mi segundo semestre fue cuando mi mamá tuvo su accidente vascular.
Regresión Lineal
Agosto de 2020
Un poco por practicar Processing y otro tanto para tener un recurso gráfico y no estar usando Excel. El (segundo) posgrado del DASC duró pocos años, pero me tocó impartir estadística y aproveché de desarrollar varias cosas, tanto en R como en otros lenguajes.
Ahora que lo pongo en esta página web, aprovecho de agregarle lo que dejé pendiente.
El repositorio se encuentra en github.com/mancpato/RegresionLineal.
PromedioImg
Agosto de 2020
Un programa sencillo para ilustrar una forma de mejorar imágenes que tienen ruido aleatorio. Mi amigo Eduardo Sández, colega del Tec de Mulegé, trajo un grupo de estudiantes y con todo gusto les di una charla breve sobre el tema.
Tomé una foto de Irma, le puse un ruido conocido como sal y pimienta e iteré promediando para que vieran la manera como mejoraba la imagen. No es la mejor técnica para quitar ese ruido, pero era rápido de programar. Usé Processing y todos contentos.
El código se encuentra en github.com/mancpato/PromedioImg.
Baúl de los recuerdos
Cómo comencé a programar
Julio de 2026
Ya me gustaban las matemáticas desde la secundaria cuando inicié mi aventura de programar computadoras en la prepa (primero BASIC en una Tandy2, luego C sobre un SO UNIX V). Fue inmediato juntar los dos mundos. Eso se formalizó hasta el tercer semestre de la carrera de matemáticas, en métodos numéricos, una de mis asignaturas favoritas. Pero esta historia requiere hacerle más honor, mi recorrido es, de alguna manera, la historia de la programación, desde mi limitada perspectiva.
Métodos numéricos, análisis numérico, cómputo científico, computación de alto rendimiento, simulación, … hay muchas líneas de trabajo pero me gusta simplificar y llamarlas de manera genérica programación numérica. No es un término estándar, pero prefiero usarlo para referirme a toda esta área de trabajo.
Algunos cursos que llevé en el posgrado fueron de una utilidad enorme, pero mi forma de trabajo cambió la primera vez que impartí Sistemas Operativos en un posgrado que hubo en la UABCS y luego Programación de Sistemas en una carrera de nivel superior. De ahí, programar en Linux fue rutina, siempre con Makefile y repositorios fue rutina. Ya los conocía, pero no les daba tanto uso.
Retomo aquí un texto que publiqué en Facebook el 19 de octubre de 2025: Hace pocos días Irma se encontró un libro viejo “El Entorno de Programación Unix”, con la nota de compra por 11 mil pesos, marcada ya en las páginas. De repente me trajo muchas cosas a la memoria. Dejo constancia.
En segundo de secundaria en 1983, me maravilló mi calculadora científica CASIO FX 82. Leí el manual y aprendí casi todo (había unas cosas de estadística que no entendía, sigmas y no se qué más). En 1985 llevé mi primer curso de programación, BASIC, en Logical, de Carlos Lage, y mi papá compró una Tandy 2, la Color Computer que se conectaba a la televisión. Había que capturar el código de algún juego, disfrutar un rato y al apagarla, se perdía todo. No importaba, era la gran cosa y luego llegaron los medios para grabar cosas, casetes y luego floppys.
Poco después, tuve una Casio PB110, pequeña computadora portátil que tenía increibles 544 bytes de memoria y espacio para 10 programas en BASIC. Era lo máximo, calculadora, banco de datos y programable. (Mi papá tuvo la PB410, con 1554 bytes). Mi PB110 me acompañó incluso mis primeros años en la UNISON, desde 1989. Eduardo Frias le agregó un programa sencillo para calcular números primos. Aún la tengo, pero ya no funciona.
En 1987 inició el centro de cómputo de la Benemerita Normal Urbana, donde tenían una máquina NCR con sistema operativo UNIX V. Mi papá, entusiasmado con el asunto, me invitó varias veces y allí hice mis pininos programando el shell y conociendo algunas de sus herramientas, como el sed y el awk. Dos libros eran los pilares: “El Entorno de Programación UNIX” de Kernighan y “El Lenguaje de Programación C” de Ritchie. Por esos años también encontré el Scraton de Métodos Numéricos, que juntaba dos cosas que me embobaban, matemáticas y programación. Le entendí muy poco. El primer semestre del 1989 estuve trabajando en la BENU, antes de irme a la UNISON, un semestre de aprender muchísimas cosas. Sentí que ya sabía programar.
Ya en la universidad me enseñaron Fortran y lo usé pocos años para hacer programas para Pedro Flores, pero pronto cambiamos todo para usar lenguaje C y comencé con estructuras de datos. Estábamos haciendo optimización sobre redes (grafos). En el cubículo de Antonio Sánchez encontré una joya: “The Elements of Programming Style”, un libro de Kernighan de 1974. Wow, me abrió los ojos a muchas cosas que nunca me habían dicho sobre cómo programar bien. En esos mismos años encontré (en Sanborns) otro libro fantástico sobre programación avanzada donde conocí la todopoderosa int86 y aprendí a trabajar de manera directa con la memoria de video. Programé mi primer menú en modo texto. Me sentía superior. En esos mismos años, otro libro que resultó muy valioso fue el de “Ingeniería de Software” de Pressman, pero hasta después entendí su relevancia. Ahora sí sentí que ya sabía programar.
Me fui al posgrado y comencé a usar un poco de c++. El libro “Introduction to Algorithms” de Cormen comenzó a ser nuestra biblia, además de “El Arte de Programar Computadoras” de Knuth, el antiguo testamento. Un poco menos, el de “Sistemas Operativos Modernos” de Tenenbaum. Terminando el primer año de créditos, tuve la osadía de comenzar a dar clases en la Escuela Superior de Cómputo del IPN en 1994, donde tuve la fortuna de conocer alumnos con excelentes habilidades para programar y pude comenzar a transferir muchas de las cosas que había aprendido desde 10 años atrás. Ahora sí sentí que ya sabía programar.
En 1999, me vine a la UABCS y por google encontré el libro “The Practice of Programming de Kernighan”, escrito más de 20 años después del primero, con notables diferencias que reflejaban cambios profundos en la manera de programar. Me atraganté con ese libro. En esa época leí muchos artículos de la ACM al respecto. Pocos años después, “Code Complete” de MacConnell llegó a mis manos. Me encantó, pero no correspondía a mis asignaturas, así que un tiempo lo tuvo mi colega Italia Estrada, que daba ingeniería de software. Luego me lo llevé a un sabático en Hermosillo y con mi colega Edelmira Rodríguez separamos los checklist para hacer un folleto para estudiantes. Pocos años después, me llegó el libro “Clean Code” de Martin, con ideas diferentes pero complementarias.
Para ese entonces, los cursos de inteligencia artificial y estadística ya me habían hecho incursionar en R y Processing. Nunca dejé el C y tuve que agregar Matlab para cosas numéricas. Poder usar bajo o alto nivel sí funciona. Definitivamente sentía que ya sabía programar. Desde hace pocos años sólo doy cursos de matemáticas, pero sin dejar de hacer programas, aunque más sencillos en muchos casos. Con la llegada de los modelos de lenguajes como ChatGPT, Claude, Julius o Gemini, la generación de código nos pone en otro panorama. Mucho de lo que he aprendido tiene que cambiar, lo mismo que la manera de enseñarlo. Ahora, 40 años después de comenzar con BASIC, estoy seguro de que no terminaré de aprender a programar.
En ese texto, faltó la experiencia con CUDA.
PAREIMM
1992/1993
(en construcción)
Programa de Análisis de Redes fue el nombre que nos gustó a quienes lo desarrollamos. Fuimos 4 estudiantes de matemáticas los que nos animamos a tomar los cursos optativos que Pedro Flores ofreció sobre optimización: Edelmira, Irene, Myriam y yo. De la primera letra de nuestros nombres sale EIMM, con lo que tenemos el nombre completo del proyecto, PAREIMM. Implementamos en C los algoritmos Prim, Kruskal, Floyd y Dijkstra. Pedro Flores nos asesoró.
No teniendo formación como desarrolladores de sistemas, creo que fue una buena hazaña de esa época, mucho que aprender. El sistema de menúes en modo texto lo hice yo y se pegaron así los 4 programas individuales con un editor en modo texto para las redes y el manejo de archivos. Creo que ese fue mi primer gran programa, además colaborando con grandes amigas.
Mi tesis de licenciatura
julio de 1993
Estudié e implementé un problema de optimización lineal: el método Símplex especializado en redes. El trabajo fue desarrollado en el Departamento de Matemáticas de la Universidad de Sonora. Tesis dirigida por Pedro Flores Pérez. La terminé en el verano de 1993. La presenté un viernes, me dieron mi acta de examen profesional el lunes. El martes ya estaba en la Sección de Computación del Departamento de Ingeniería Eléctrica del CINVESTAV.
El repositorio se encuentra en github.com/mancpato/MiSimplex. El código fue desarrollado usando Borland C/C++ (3.0 o 3.1) y el documento escrito usando LaTeX.
Esas versiones no compilaban por la versión/dependencia de software, pero las traje de vuelta a la vida, sin tocar las versiones originales. Por eso en el repositorio tiene los directorios Src1993 y SrcNew.
El código en LaTeX no se ha modernizado y no compila.
MkTree
septiembre de 1993
El primer cuatrimestre de la maestría en el CINVESTAV, cursaba Lógica Matemática del Dr. Guillermo Morales. Una de las primeras tareas fue una tabla de verdad para \(n\) variables. Tuve la afortunada ocurrencia de tratar de construir el árbol sintáctico completo en memoria, para luego evaluarlo con facilidad. Mis otros compañeros se fueron por la opción de hacer un analizador recursivo, un parser más sencillo. Para mí ambos eran desconocidos, yo no venía del área de computación, y opté por construir el árbol en memoria. La experiencia con árboles en mi tesis de licenciatura me daba confianza.
Este programa me costó varios días, menos de una semana, recuerdo, pero trabajábamos todo el día en el CINVESTAV. MkTree (así lo llamé) toma una fórmula proposicional escrita como cadena de texto — con ^, |, ->, <-> y negación — y construye su árbol sintáctico respetando la precedencia entre conectivos. Sobre ese árbol se apoyaba un programa completo de tablas de verdad, con su propia interfaz de ventanas en modo texto de la época.
Lo que no esperaba es que el mismo esqueleto — convertir una cadena en árbol, y luego manipular el árbol — me sirviera para más que tablas de verdad. Con el árbol ya construido, podíamos ordenarlo a una forma canónica y compararlo con otros, un ladrillo natural hacia la demostración automática de teoremas: unir árboles simples para construir expresiones más grandes o reconstruir la nueva cadena a partir del árbol resultante. Todos en el curso lo adoptamos para los siguientes programas. Y cuando después llevamos un curso de autómatas y lenguajes formales, reciclé la misma idea, cambiando los conectivos lógicos por los del álgebra de expresiones regulares, para simplificar las expresiones enredadas que salen de eliminar estados de un autómata.
Ese cuatrimestre, y los que le siguieron, MkTree se volvió la pieza que varios de nosotros reutilizábamos sin pensarlo dos veces. Compilaba en Borland C/C++ 3.1, con los servicios de conio.h y longjmp.h, todas las señas típicas de su época. Hoy ni compila, y viéndolo con mi ojo crítico actual, tiene sus fallas. Pero la idea de fondo — parsear, construir el árbol, reescribir sobre él — no envejeció mal en absoluto. Se gana su lugar en este baúl de los recuerdos.
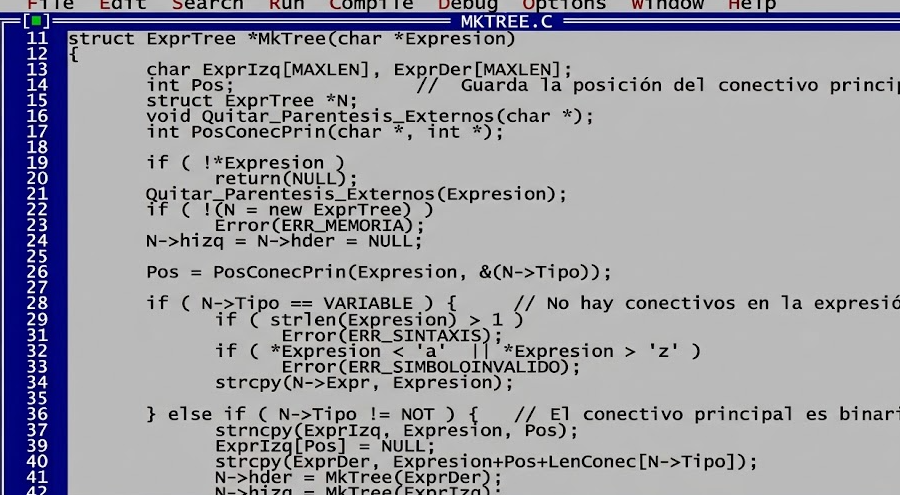
Recreación visual con IA, no una captura de pantalla real.
📥 Código original (sin modificar): MKTREE.C · EXPRTREE.H